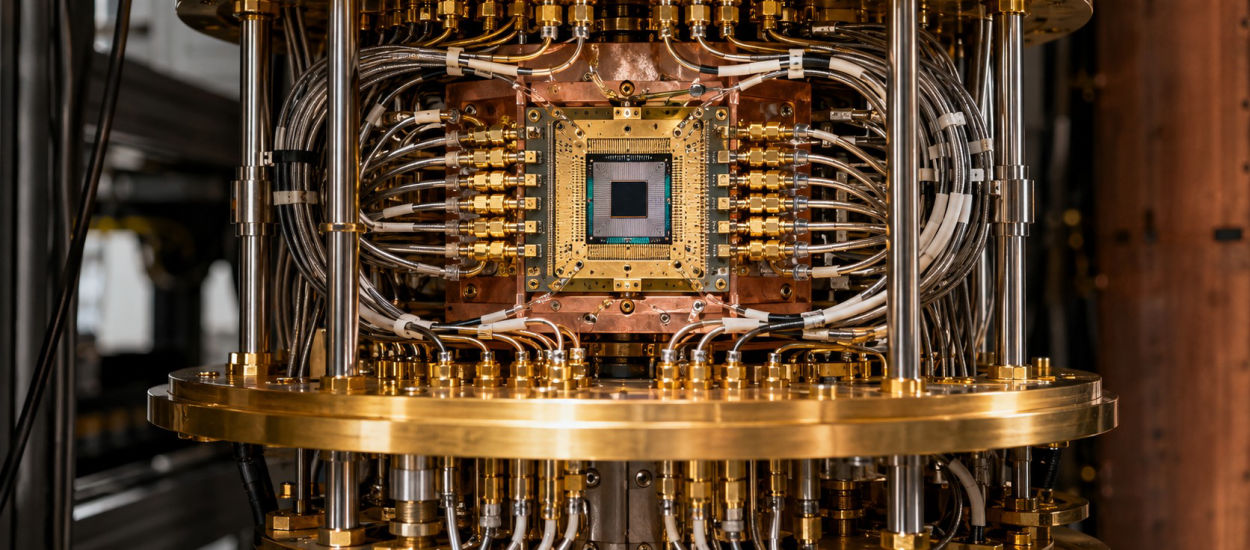
Maszyna firmy IBM wygenerowała próbki z obwodu w czasie 16,1 minuty, co stanowi znaczące osiągnięcie, biorąc pod uwagę, że dla standardowych komputerów byłoby to zadanie bardzo skomplikowane. Kluczowym elementem tego przedsięwzięcia było ustalenie dolnego progu statystycznej wierności obliczeń bez konieczności powtarzania całego eksperymentu, jak to miało miejsce w metodach klasycznych.
Zespół badawczy z IBM Research oraz Uniwersytetu w Chicago podzielił się swoim osiągnięciem w preprincie opublikowanym na platformie arXiv. Nie chodzi tutaj o tworzenie molekuł, poszukiwanie nowych leków czy rozwiązywanie problemów genetycznych, lecz o zadanie z zakresu próbkowania, skonstruowane w celu sprawdzenia granic klasycznych symulacji. Jak zauważają autorzy, eksperyment ten ma na celu demonstrowanie „przewagi kwantowej”: jego trudność wynika z ustaleń teoretycznych, a błędy sprzętowe były kontrolowane, co pozwoliło na ocenę wiarygodności wykonania. To kluczowy element, który odróżnia to osiągnięcie od wcześniejszych demonstracji.
Kto zweryfikuje Twój wynik?
Losowy rozkład próbkowania stał się popularnym testem zdolności komputerów kwantowych. W ramach tego testu maszyna generuje rozkład wyników, którego odtworzenie staje się niezwykle trudne (i kosztowne) dla komputerów klasycznych. Jeśli klasyczna maszyna nie ma szans powtórzyć tych samych obliczeń, pojawia się pytanie, jak sprawdzić, czy kwantowy odpowiednik wykonał obliczenia poprawnie. Używane wskaźniki wierności często opierają się na założeniach dotyczących rozkładów szumów i ich charakterystyki. Zasada jest prosta: im trudniejsze zadanie, tym trudniejsza jego weryfikacja przypomina próbę „wygenerowania” klucza do zamka. W tym kontekście ważne jest posiadanie odpowiedniego wzorca, który oceni dokładność maszyny kwantowej w generowaniu spreparowanego klucza. Musimy mieć metodę porównawczą, aby stwierdzić: „maszyna kwantowa wykonała zadanie dobrze”. Interesuje nas także nie tylko to, czy zadanie zostało wykonane, ale także, czy było to wykonane dokładnie.
Autorzy użyli próbkowania z obwodów Clifforda wzbogaconych o bramki T. Stan generowany przez taki obwód Clifforda można dodatkowo kontrolować klasycznie, a pomiary ujawniają część błędów, które występują podczas działania systemu. Następnie naukowcy dodali 468 bramek T, co zwiększyło tzw. „magiczność” stanu, zachowując jednocześnie strukturę mechanizmu detekcji błędów.
Porównanie obu wariantów umożliwiło wyznaczenie dolnej granicy wierności stanu, zamiast obliczania pełnego wyniku będącego wzorcem. Metoda ta jest w stanie tolerować silniejsze szumy, w tym te mniej równomierne niż w przypadku wcześniejszych testów, chociaż wciąż zakłada model błędów Pauliego.
97 fizycznych kubitów
Eksperyment przeprowadzono na nadprzewodnikowym procesorze IBM-a Boston, który pracuje z 70 kubitami dla danych i 27 stanowiącymi elementy pomocnicze. Obwód związany był z 2415 operacjami CZ, a kolejne 454 dedykowane były do sprzęgania kubitów pomocniczych podczas odczytu syndromów. Kod czasoprzestrzenny wykrywał 92 proc. błędów pierwszego rzędu, obniżając efektywny współczynnik błędów CZ do 1,8 x 10^-4, co jest około dziesięć razy lepsze niż w przypadku obliczeń fizycznych przeprowadzanych przez maszynę. Wyznaczenie dolnej granicy wierności końcowego stanu osiągnięto na poziomie 0,284 przy 95-procentowym poziomie ufności.
Jednak takie osiągnięcia mają swoją cenę, której nikt nam nie odda – czas: selekcja na podstawie syndromów zmniejszyła efektywne tempo próbkowania około 860 razy. Po odrzuceniu pomiarów, które wykazywały błędy, pozostało 2051 próbek, zebranych w ciągu 16,1 minuty pracy w ramach badanych obwodów.
Warto jednak podkreślić, że cały proces nie zakończył się w kwadrans. Walidacja w postaci pomiarów różnych wariantów była przeprowadzana przez… osiem godzin, aby nawet subtelne zmiany parametrów urządzenia wpływały na wyniki w podobny sposób. 16,1 minuty odnosi się do najtrudniejszej obliczeniowo części, a nie pełnego procesu przygotowania, kalibracji maszyny i późniejszego sprawdzenia rezultatu eksperymentu.
Demonstracja jest mocna. Ale czy to werdykt rozstrzygający?
Aby potwierdzić swoje twierdzenia, autorzy przeanalizowali także istotne techniki symulacji oparte na sieciach tensorowych, rozkładach stabilizatorowych oraz metodach hybrydowych. Dla obwodu łączącego silne splątania z 468 bramkami T, żadna z rozpatrywanych metod nie okazała się skuteczna. Nie oznacza to jednak, że wszystkie obecne i przyszłe metody klasyczne muszą przegrać w porównaniu do tej konkretnej. Autorzy podkreślają, że lepsze algorytmy i klasyczne maszyny mogą z czasem zmienić oszacowanie „kosztu” przeprowadzenia takiej symulacji.
Czytaj także: Potężny komputer kwantowy już wkrótce w Polsce. To będzie duma Zielonej Góry.
Zanim jednak uruchomimy wszelkie fanfary, należy pamiętać, że mamy do czynienia z preprincem, a nawet certyfikowany wynik nie weryfikuje rezultatu całkowicie niezależnie od podstawowych założeń dotyczących samego komputera kwantowego. Wprowadzone rozwiązania skutecznie wykrywają błędy i eliminują nieudane przebiegi, jednak wiemy również, że przy dalszym skalowaniu narzut związany z tak radykalną selekcją stanie się przeszkodą dla większości laboratoriów zajmujących się komputerami kwantowymi.
IBM osiągnął coś wyjątkowego, ale jednocześnie nie dostarczył uniwersalnej, odpornej na błędy maszyny, gotowej do rozwiązywania problemów przemysłowych na szeroką skalę. Zrevealedł natomiast, że trudność, tłumienie błędów oraz ilościowa ocena wiarygodności wyników mogą być ze sobą kompatybilne: a właśnie tego brakowało w wykazywaniu niepodważalnej przewagi metod kwantowych nad klasycznymi.