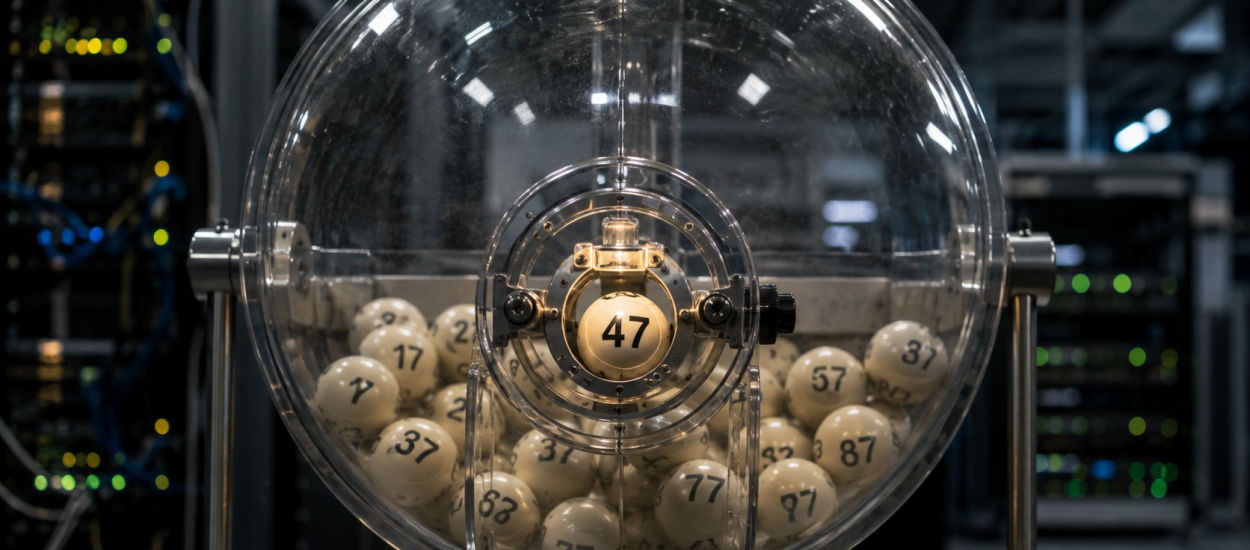
GPT-4.1, zapytany o wybór liczby z zakresu od 0 do 100 tysięcy, aż w co trzecim przypadku wskazał cyfrę 7. W porównaniu z danymi 6981 ludzi, jego wyniki prezentowały się blado, ponieważ ludzie znacznie lepiej zbliżyli się do rozkładu równomiernego.
Eksperyment opisany przez Nathana Beddome’a uwzględniał trzy zestawy danych: 10 tysięcy odpowiedzi GPT-4.1, odpowiedzi 6981 internautów oraz 10 tysięcy liczb wygenerowanych przez system z losowym generatorem liczb. Model otrzymywał zawsze tę samą instrukcję, by zwrócić jedną liczbę całkowitą w przedziale od 1 do 100, a każde zapytanie wysyłano oddzielnie. Choć teoretycznie każda liczba powinna mieć 1% prawdopodobieństwa wyboru, w praktycznych próbach istotna jest skala rozkładu, która w przypadku ograniczonej próby częstości, nie odzwierciedla idealnego rozkładu. Zakres był zbyt wąski, a próba, która mogłaby wykazać idealny rozkład równomierny, musiałaby być ogromna. GPT-4.1 okazał się jednak tak mocno „ukierunkowany” na wybór lub unikanie konkretnych liczb, że nie był w stanie dorównać losowości prezentowanej przez ochotników.
GPT-4.1 unikał skrajności i niemal wszystkich pełnych dziesiątek
Interesujące jest to, że model ani razu nie wybrał liczb 1, 5, 6, 20, 30, 40, 50, 60, 70, 80, 90 oraz 100. Tylko 0,01% odpowiedzi kończyło się zerem, a jedyną taką liczbą była liczba 10. Zaledwie 0,1% wskazań mieściło się w zakresie od 1 do 9, podczas gdy wyniki wyraźnie koncentrowały się bliżej środka rozkładu. Najczęściej wybieraną liczbą okazała się liczba 47, która była wybierana sześć razy częściej niż przewidywałaby to równomierna dystrybucja.
Liczba 7 dominowała w całym rozkładzie, choć sama w sobie pojawiała się rzadko. Stanowiła 29% wszystkich wskazań, a wśród liczby najczęściej „losowo” wybieranych znalazły się 47, 57, 37, 67 i 87. Można dostrzec wyraźny wzorzec, który ujawnia się po zebraniu tysięcy niezależnych odpowiedzi. Test chi-kwadrat przeprowadzony przez autorów pierwotnych danych potwierdził silne rozbieżności między rozkładem GPT-4.1 a rozkładem równomiernym. Z mojego punktu widzenia, nie było potrzeby przeprowadzania testów chi-kwadrat (przypomniałem sobie zajęcia ze statystyki, które były dla mnie wyzwaniem), ale dla naukowej rzetelności, lepiej było to zrobić. Niezgodność ta jest widoczna gołym okiem, zarówno w odpowiedziach modelu, jak i na odpowiednich wykresach.
Człowiek nie jest idealnym generatorem liczb losowych
Ludzkie odpowiedzi pochodziły bezpośrednio z wątku na Reddicie, dlatego nie można ich uznać za reprezentatywne dla całej populacji. Preferencje uczestników były dość wyraźne: 69 (prawdopodobnie w formie internetowego żartu) wybierano 2,9 razy częściej niż przewidywałoby to losowanie, 77 – 2,4 razy częściej, a 7 – dwukrotnie częściej. Po drugiej stronie spektrum znalazła się liczba 85, która była znacznie niedoszacowana. Wyjątkowe preferencje występowały, ale… wszystkie części zakresu były reprezentowane znacznie równiej niż w wynikach modelu. GPT-4.1, będący już starszym modelem OpenAI, zatem nie sprawdzał się w generowaniu losowych liczb. Osobiście ciekaw jestem, jak poradziłby sobie model 5.6 Sol, i jeśli znajdę czas w weekend, mogę spróbować tego sprawdzić, choć pewnie uzyskanie prób o skali powyższego badania może okazać się „ciekawym” wyzwaniem.
W ramach porównania zastosowano miarę różnicy między dwoma rozkładami prawdopodobieństwa. Wartość 0 oznacza rozkłady identyczne, a 100% – całkowicie rozłączne. Autor analizy uzyskał 12% dla ludzi w odniesieniu do komputerowej próby kontrolnej oraz 48% dla GPT-4.1: na tej podstawie sformułowano wniosek, że ludzie byli „cztery razy bardziej losowi” w doborze liczb niż GPT-4.1. Bezpośrednia różnica między rozkładami odpowiedzi człowieka i modelu wyniosła 53%, jednak należy to traktować jako opis porównywanych zbiorów. Nie wyciągałbym dalekosiężnych wniosków, że jesteśmy w taki sposób „bardziej losowi” od dużych modeli językowych.
Model językowy nie gra w kości
Wszystko wynika z konstrukcji LLM-ów, co skłania mnie do sformułowania tytułowej sugestii. Naprawdę, nie powinno się prosić nawet świetnego GPT-5.6 Sol o wybór losowej liczby. To nie jest generator liczb losowych. Nie posiada mechanizmu, który z automatu gwarantuje równomierne losowanie liczb; on po prostu dobiera kolejne tokeny na podstawie wyuczonego rozkładu. Będzie faworyzował wartości związane z kulturą lub badaniami, które ludzie mogą postrzegać jako „losowe”: niemal wszystkie pełne dziesiątki mogą być ignorowane i teraz. Jednak sama obecność ludzkich uprzedzeń w danych treningowych nie wyjaśnia wszystkiego. Uprzedzenia te istnieją, a niektóre społeczeństwa azjatyckie wybierają liczbę 4 rzadziej od innych. Dlaczego? Na przykład w kulturze japońskiej (shi) liczba ta kojarzy się ze śmiercią ze względu na podobieństwo brzmieniowe do słowa oznaczającego koniec życia. W krajach, w których panuje takie podejście do liczby 4, opisuje się nawet zjawisko tzw. „tetrafobii”, czyli lęku przed tą liczbą.
Możliwości ciekawej analizy otwiera także zastosowanie zaawansowanego watermarkingu w sztucznej inteligencji, ponieważ może to wpływać na to, co znajduje się w tokenach i ich geometrię (w ogromnym uproszczeniu). Załóżmy, że AI wdroży watermarking również do generowanych liczb losowych, które w jednym wygenerowanym zestawie będą musiały wynosić dokładnie 10 000. Wyniki mogłyby być interesujące nawet bez watermarkingu. Jednakże, jeśli watermarking ma wpływać na wybór słów, może to z kolei skłaniać model do inaczej dobierania liczb losowych. Może… nawet bardziej losowo? To pozostaje do zbadania – traktujcie to jako luźną myśl.
Czytaj również: Próbował oszukać sąd sztuczną inteligencją. Sąd zaskoczył go i pokonał.
Ciekawe informacje w tej kwestii prezentuje materiał ACL z tego roku: spośród 11 testowanych modeli na 15 rozkładach, aż 10 nie zdało żadnego testu równomierności przy serii niezależnych zapytań. Dlatego, gdy losowość ma kluczowe znaczenie dla twardych statystyk, bezpieczeństwa lub doboru próby, model powinien skorzystać z narzędzia zewnętrznego i dopiero później podać wynik, a nie generować go samodzielnie. Oczywiście, nie każdy ChatGPT i nie zawsze zachowa się w identyczny sposób, ale wiadomo, że takie zastosowania LLM-ów są średnio skuteczne. To było zresztą oczekiwane, w związku z ich konstrukcją. Traktowanie dzisiejszych mechanizmów AI jako „recepty na wszystko” to ślepa uliczka i warto o tym pamiętać.