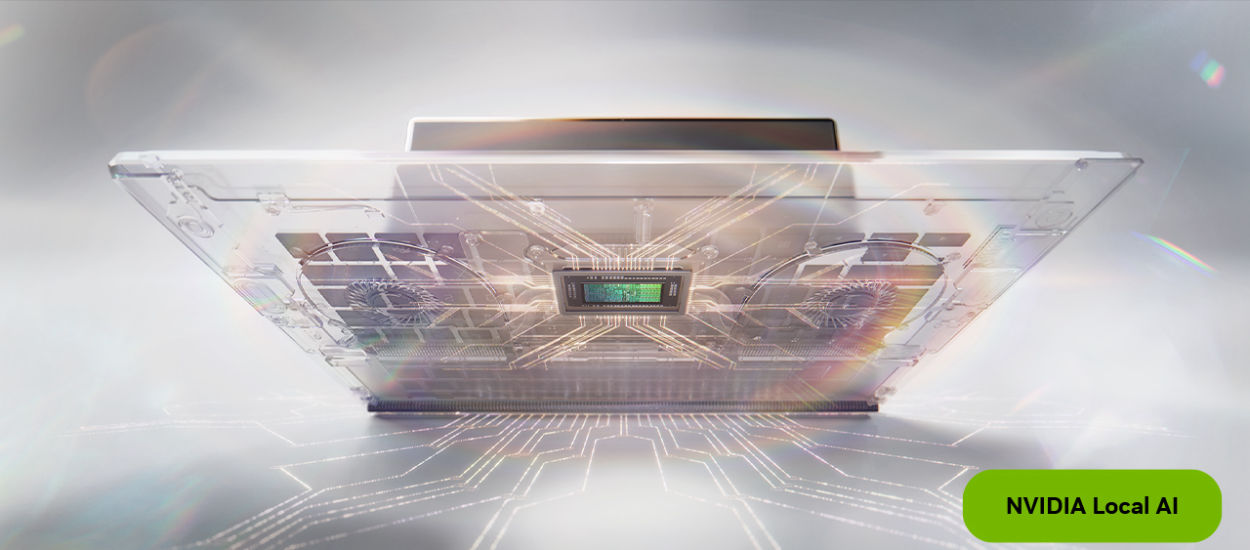
Przed nadchodzącymi targami IFA 2026, NVIDIA ogłosiła datę premiery komputerów wyposażonych w układ RTX Spark. Firma zaprezentowała również otwartoźródłowe narzędzie PAIR, które umożliwia podział zadań AI pomiędzy różne urządzenia w domu.
RTX Spark N1X w dwóch wariantach
Pierwszy układ z rodziny RTX Spark, model N1X, trafi do sprzedaży w październiku w dwóch wersjach. Mocniejszy z wariantów łączy GPU Blackwell z 6144 rdzeniami CUDA, 20-rdzeniowym procesorem Grace oraz pamięcią zunifikowaną od 24 do 128 GB. Zostanie zastosowany w laptopach oraz niewielkich komputerach stacjonarnych. Słabsza wersja będzie dysponować 5120 rdzeniami CUDA, 18-rdzeniowym procesorem oraz pamięcią od 24 do 32 GB, jednak na razie dostępna będzie jedynie w laptopach. Oba modele będą sprzedawane pod oznaczeniem N1X, dlatego istotne będzie zwracanie uwagi na ich specyfikacje.
Komputery z nowym układem przygotowują takie firmy jak ASUS, Acer, Dell, HP, Lenovo, Microsoft oraz MSI. Ich dostępność będzie uzależniona od producenta oraz regionu, a ceny nie zostały jeszcze ogłoszone.
RTX Spark oparty jest na architekturze ARM, dlatego dla graczy istotna będzie zgodność z systemami chroniącymi przed oszustwami. Wsparcie dla tej architektury już zapowiedziały takie firmy jak EA, Epic Games, Riot Games, Ubisoft, Embark oraz Krafton.
NVIDIA PAIR: kilka komputerów, jedna kolejka zapytań
NVIDIA PAIR (Personal AI Router) można zainstalować na każdym komputerze, który ma być częścią domowego klastra. Urządzenia wykrywają się nawzajem za pomocą protokołu mDNS, parując się przy użyciu sześciocyfrowego kodu, a komunikacja odbywa się za pośrednictwem szyfrowanego połączenia mTLS. Program współpracuje z Ollamą oraz LM Studio, kierując zapytania do wybranych maszyn w sieci.
PAIR nie dzieli jednego modelu między kilka kart graficznych. Każde zapytanie trafia w całości do jednego węzła, co oznacza, że model nadal musi zmieścić się w pamięci pojedynczego komputera. Rozwiązanie to przyspiesza pracę tylko wtedy, gdy agent wykonuje wiele zadań równocześnie. Podczas demonstracji, zadania pięciu pomocniczych agentów zostały rozdzielone między komputer z RTX 5090, laptop z RTX Spark oraz stację DGX Spark. Cała operacja zajęła mniej niż 10 minut, co w porównaniu do około 18 minut na jednej maszynie, stanowi znaczną oszczędność czasu.
Wersja beta PAIR przydziela zadania na podstawie długości kolejki oraz obciążenia GPU. Omija również komputer, na którym trwa gra lub renderowanie. PAIR obsługuje systemy Windows, Linux oraz macOS i nie wymaga kart NVIDII. Wystarczy sprzęt zgodny z Ollamą lub LM Studio, co pozwala na dołączenie do klastra np. MacBooka z procesorem Apple. Bezpłatny program zostanie udostępniony 3 września na licencji Apache 2.0.
Prostsza instalacja lokalnych agentów
Hermes Agent we wrześniu zyska kreatora, który dobierze, pobierze i skonfiguruje lokalny model na komputerach z RTX oraz DGX działających pod systemem Windows lub Linux. Podobne funkcje ma wprowadzić aplikacja OpenClaw dla systemu Windows. Perplexity z kolei zapowiada wersję swojego lokalnego agenta Portable Computer na karty RTX. Gdy lokalny model nie poradzi sobie z zadaniem, program przekaże je do chmury.
NVIDIA ogłosiła również optymalizacje dla narzędzi llama.cpp oraz vLLM. Zgodnie z informacjami od firmy, llama.cpp oferuje teraz do 1,6 razy wyższą przepustowość, natomiast vLLM działa do 1,4 razy szybciej na dwóch połączonych stacjach DGX Spark. Zmiany te zostały już wdrożone w llama.cpp, LM Studio, Ollamie oraz vLLM.