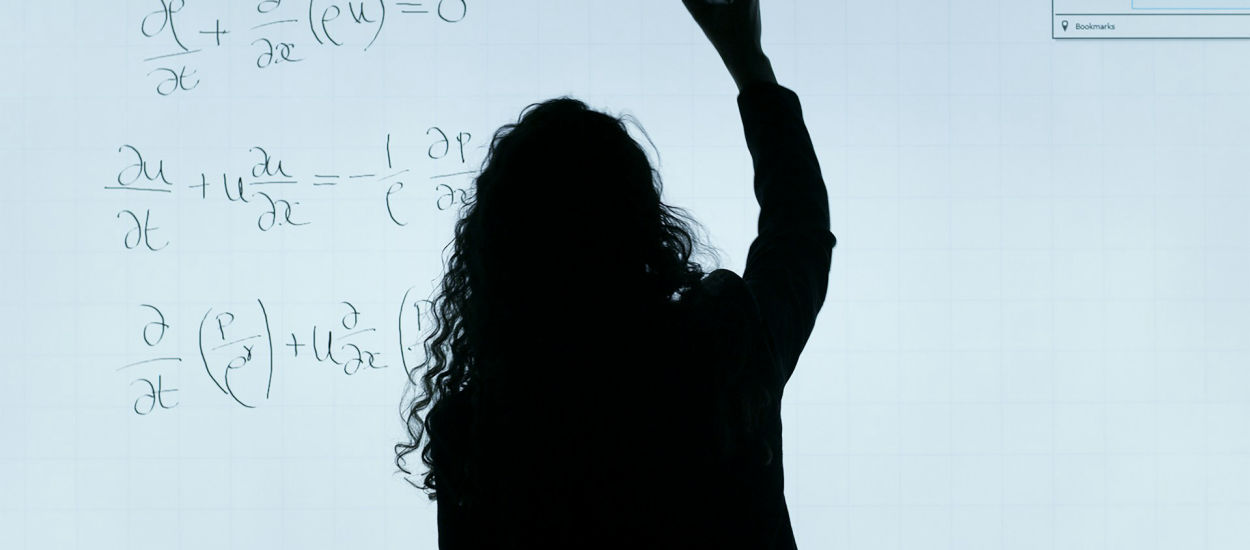
OpenAI ogłosiło wczoraj, że jego algorytm sztucznej inteligencji rozwiązał problem Naviera-Stokesa, za który została przyznana nagroda w wysokości miliona dolarów. I wszystko byłoby w porządku, gdyby nie to, że OpenAI działało jak typowa, bezwzględna korporacja, starając się zminimalizować wkład dwóch matematyków oraz ich badania — oraz skandaliczne pominięcie jednego z autorów, którego zatrudnia konkurencja, firma Anthropic.
Gigant ogłosił propozycję rozwiązania jednego z siedmiu problemów milenijnych, z których każdy jest wart milion dolarów. Firma wykorzystała nieujawniony jeszcze model, który według niej znacznie przewyższa możliwości GPT-6. OpenAI wskazało na 165-stronicowy dowód oraz jego formalizację w Leanie, co służy badaczom do komputerowego weryfikowania matematycznych rozumowań.
Prace nad problemem Naviera-Stokesa, według firmy, pochłonęły około 130 miliardów tokenów wyjściowych, co szacunkowo kosztuje… około 15 milionów dolarów. (To porównanie nie mówi jednak, jaka jest rzeczywista wartość rozwiązania problemu.) Ale to nie jest najważniejsze. Kluczowe jest, jak OpenAI zachowało się w tej sytuacji: niestety, zachowało się w sposób tragiczny, co ujawnili naukowcy korzystający z Codexa w próbie rozwiązania problemu, którzy również znajdowali się na tropie rozwiązania.
OpenAI powtarza historie najgorszych korporacji. To smutne
Tristan Buckmaster z Uniwersytetu Nowojorskiego oraz Levent Alpöge, pracownik Anthropic, wcześniej pracowali nad pokrewnymi problemami. Była to ich prywatna inicjatywa, w której korzystali z modelu Claude’a oraz narzędzi OpenAI. Ich punktem wyjścia było podejście opracowane przez Diega Córdobę i Luisa Martíneza-Zoroę. Zaproponowane przez nich wyniki obejmowały osobliwości w równaniach Eulera z tzw. gładkim wymuszeniem, opisującym płyn bez uwzględniania lepkości, co samo w sobie nie jest rozwiązaniem problemu Naviera-Stokesa.
OpenAI przyznało, że rozpoczęło próbę 1 września po pojawieniu się pogłosków, które później powiązało z pracą tej dwójki. Oczywiście, szybko pojawiły się spekulacje, że OpenAI mogło… przeglądać sesje badaczy, aczkolwiek firma zaprzeczyła, jakoby to miało miejsce. Altman później tłumaczył w serwisie X, że jego zespół był ciekaw, czy jego własne modele są w stanie poradzić sobie z problemem Naviera-Stokesa w ramach tego kierunku.
W swoim oświadczeniu, które opisuje rozmowy z OpenAI z 6 września, Buckmaster donosi, że zaproponowano mu samodzielne opracowanie artykułu o dowodzie OpenAI, ale z pominięciem Alpöge’ego. Powodem miało być jedynie to, że jego kolega zatrudniony jest u konkurencji: wiadomo bowiem, że w branży panuje antagonizm między OpenAI a Anthropic. Nawet sami CEO, Altman i Dario Amodei, szczerze się nie cierpią. Kiedy zszokowany (i słusznie) badacz zapowiedział upublicznienie sprawy, usłyszał pytanie, dlaczego miałby w ten sposób zrujnować swoją karierę. Nie ugiął się, odrzucił zaproponowane warunki i opublikował własną relację z rozmów. I słusznie, bo OpenAI obecnie stara się PR-owo opanować pożar, który sam zapalił.
O co chodzi w tym problemie?
Równania Naviera-Stokesa opisują ruch płynów, w tym wody oraz powietrza, i są wykorzystywane m.in. w prognozowaniu pogody. Problem z matematycznego punktu widzenia dotyczy tego, czy początkowo gładki przepływ trójwymiarowy może w skończonym czasie rozwinąć tzw. osobliwość. W tej konstrukcji płyn początkowo przepływa gładko, a następnie zewnętrzna siła gładko wywołuje wir, który staje się coraz ciaśniejszy i bardziej rozciągnięty. Prędkość rośnie bez ograniczeń, mimo że całkowita energia kinetyczna pozostaje skończona.
Uzyskany wynik dla problemu opisywałby granicę stosowalności modelu, który jest tzw. „typem idealnym” dla płynu traktowanego jako ośrodek ciągły. Nie sugeruje jednak, że rzeczywista woda mogłaby poruszać się nieskończenie szybko. Dopuszcza się także rozwiązanie poprzez wykazanie utraty gładkości przy odpowiednio regularnej sile zewnętrznej. OpenAI twierdzi, że spełniło warunki wariantów C i D.
OpenAI odpowiada na zarzuty
Sébastien Bubeck, który rozmawiał z Buckmasterem, odpowiedział, że nie prosił o usunięcie Alpöge’ego z autorstwa jego własnych badań. Aczkolwiek potwierdził, że uważał współautorstwo pracownika Anthropic za niewłaściwe przy opisie dowodu OpenAI. Przyznał także, że mówił o ryzykowaniu kariery przez Buckmastera i przeprosił za dobór słów. Utrzymuje jednak, że reagował tylko na groźbę bezpodstawnych oskarżeń i że jego intencją było uznanie osiągnięć obu naukowców. Powiem szczerze: wygląda to jak wymijające tłumaczenie polskiego polityka. Jeśli ktoś się na to nabierze, będzie bardzo naiwny, a OpenAI zachowało się (w osobie Bubecka) niczym obrażony przedszkolak w piaskownicy.
Nie zapominajmy jednak o kwestii szkiców, które matematycy wprowadzali do Codexa. Buckmaster pytał, czy ich prace posłużyły do treningu modelu, zaznaczając, że nie wie, czy rzeczywiście tak było. OpenAI zapewnia, że jej badacze i agenci nie widzieli ich pracy przed publikacją i nie korzystali z konkretnych danych użytkowników w celu rozwiązania problemu. Ale (i to jest DUŻE zastrzeżenie) nie wyklucza, że dane pozbawione identyfikatorów, uzyskane z używania jej produktów, mogły pomóc w ulepszaniu modeli. Dla mnie to wygląda jak furtka w sytuacji, gdyby okazało się, że OpenAI inspirowało się pracami naukowców: w razie czego będzie można to „zwalić” na naturalny mechanizm ulepszania modeli, nawet jeśli OpenAI intencjonalnie (czego raczej nie uda się udowodnić) skonfiskowało prace naukowców.
I teraz kluczowa kwestia, Szanowni Państwo. Niezależnie od tego, jak dobre produkty wytwarzają korporacje (a mnie produkty OpenAI pasują, kosztują mnie rocznie 5000 złotych i uważam to za inwestycję w mój czas i inne aktywności), to te podmioty nie są „sympatyczne”. Nie należy ich lubić, być ich fanem ani angażować się w jakiekolwiek waśnie dotyczące wyższości jednego modelu nad drugim. OpenAI znalazło się w gronie najważniejszych firm na świecie i, niestety, przyjęło także złe wzorce, które temu towarzyszą. Ale najprawdopodobniej jest tak, że gdy dołączasz do tej ligi, musisz grać według ustalonych reguł. To nie jest usprawiedliwienie, ponieważ w życiu istotne jest, aby pozostać uczciwym: a OpenAI w tej sytuacji zachowało się skrajnie nieładnie.
Kto zatem zgarnia nagrodę?
Umieszczenie szczegółów „kontroli” w Leanie zwiększa wiarygodność dowodu, ale to wciąż ludzie muszą sprawdzić, czy sformalizowane twierdzenie spełnia wszystkie warunki problemu. Do tego czasu Clay Mathematics Institute będzie traktować problem Naviera-Stokesa jako nierozwiązany. Regulamin wymaga publikacji w odpowiednim periodyku, co najmniej dwóch lat od ukazania się oraz powszechnej akceptacji społeczności matematycznej. Tylko wtedy gremium uzna, że nagroda powinna zostać przyznana. Tylko kto ją zgarnie w tej sytuacji?
Czytaj również: ChatGPT kończy erę AI Slopu. Images 2.5 rozwiązuje poważny problem.
OpenAI deklaruje, że nie będzie zabiegać o nagrodę. To jednak, umówmy się, również działanie PR-owe po wybuchu skandalu. Rezygnacja z nagrody nie rozwiązuje kwestii związanych z wkładem ludzi w rozwiązanie problemu, ani pochodzeniem danych, które umożliwiły jego rozpracowanie. Niestety, podnosi to również kwestie dla wszystkich, którzy wprowadzają ważne dane do ChatGPT i Codexa: wszystko, co się tam znajdzie, może stać się ich własnością lub być podstawą do tego, by OpenAI mogło się potem tym podpisać.
Docieramy do punktu, w którym narzędzia, które mogą wspomóc naszą pracę, mogą również skutecznie ją zniszczyć. W tej sprawie firma Altmana wyraźnie się nie popisała, co tym bardziej boli, że stanęła naprzeciw dwóch świetnych, ale „zaledwie” badaczy, którzy mają o wiele mniejszą siłę rażenia i zapewne nie dysponują zespołem PR-owców oraz prawników.